Supervisión de copias de seguridad en la nube con Acronis Cyber Backup
Acronis Cyber Backup · Acronis Cyber Protect Cloud · MIDRANGE GROUP
Contexto
En MIDRANGE GROUP (ESN/MSP francesa), dentro del equipo de Operaciones junto al administrador de sistemas y redes del equipo, me encargué de la supervisión diaria de las copias de seguridad en la nube y locales de un cliente gestionado. La infraestructura de backup se apoyaba en dos productos Acronis distintos: Acronis Cyber Backup (solución de backup local/NAS) y Acronis Cyber Protect Cloud (plataforma de backup en la nube orientada a MSP). Mi misión: revisar a diario el panel de Acronis, triar las alertas activas y restablecer la continuidad de las copias de seguridad ante cada fallo detectado.
Retos técnicos
- 85 alertas activas en 105 equipos protegidos exigían un triaje sistemático — tratar cada alerta con la misma urgencia habría ocultado los pocos casos con riesgo real de pérdida de datos.
- El mismo síntoma (un estado rojo de «fallo») podía deberse a cuatro causas raíz distintas — NAS saturado, servidor fuera de línea, plan de backup corrupto o fallo de red — así que la corrección debía ajustarse a la causa real, no solo a la etiqueta de la alerta.
- Recrear un plan de backup corrupto implicaba conservar exactamente la misma política (programación, retención, destino) bajo un nuevo nombre, sin modificar silenciosamente las ventanas de retención o los destinos de los que dependía el cliente.
- Los dos destinos NAS on-premise se acercaban a la vez a su límite de capacidad de 10,5 Tio; liberar espacio en uno sin comprobar el otro solo habría retrasado el mismo fallo.
- Diagnosticar un fallo requería a menudo acceso remoto a los propios servidores del cliente (vía Datto RMM / Splashtop) en lugar de depender solo de la consola de Acronis, ya que algunas causas raíz (un servidor desconectado, un enlace de red saturado) solo son visibles desde la propia máquina.
Infraestructura de backup
- Herramienta de backup local
- Acronis Cyber Backup (NAS / nube privada)
- Herramienta de backup en la nube
- Acronis Cyber Protect Cloud (alojado por Acronis)
- Destino NAS 1
- smb://nas-client/backups — 8,77 Tio / 10,5 Tio
- Destino NAS 2
- smb://nas-client/backups-new — 9,57 Tio / 10,5 Tio
- Destino en la nube
- Nube Acronis — 139 Gio / 250 Gio
- Dispositivos protegidos
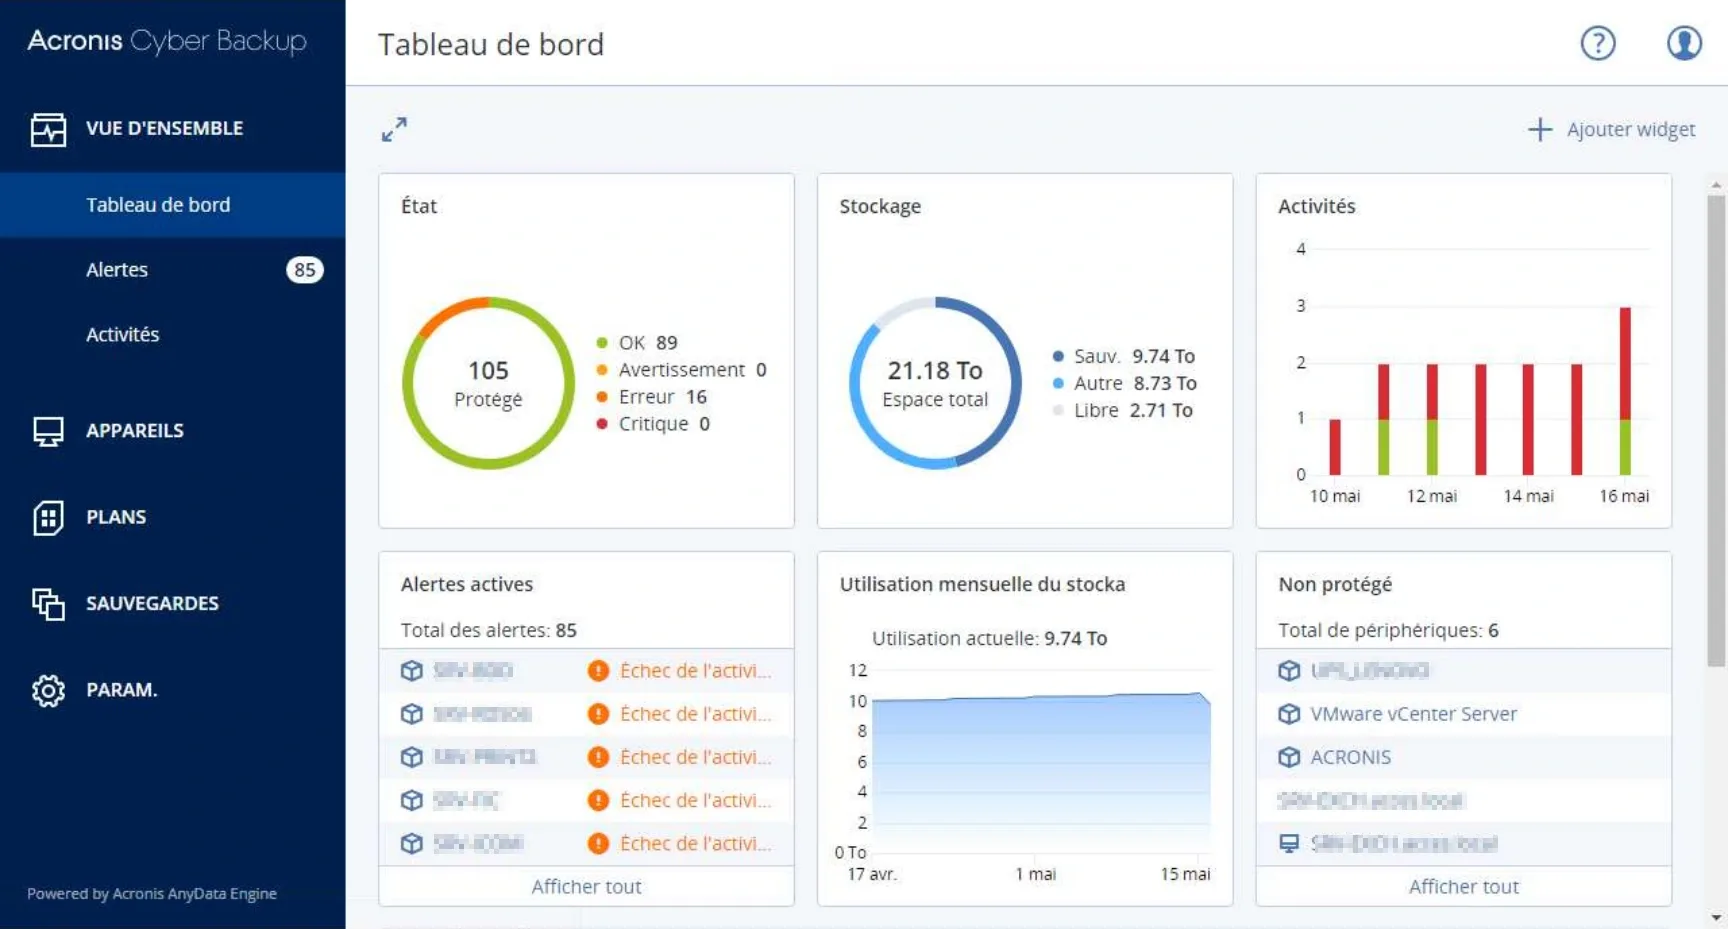
- 105 en total (89 OK, 16 con error, 0 críticos)
- Dispositivos no protegidos
- 6 (UPS-01, VMware vCenter Server, ACRONIS, SRV-MAIL-01)
- Almacenamiento total utilizado
- 9,74 Tio de backup / 21,18 Tio en total
Planes de backup
El cliente disponía de 5 planes de backup activos configurados en Acronis Cyber Backup: ‘Toutes les VM’ (todas las VM — 16 dispositivos incluyendo SRV-RDS-01, SRV-DB-01, SRV-PRINT-01 y otros 13 — programado de lunes a sábado a las 23:00, destino: smb backups-new, retención: 2 meses mensual / 4 semanas semanal / 6 días diario); ‘TMP-BDD’ (1 dispositivo); ‘SQL-CLOUD 2’ (86 dispositivos, lunes a viernes a las 23:00); ‘SQL-CLOUD’ (86 dispositivos); ‘Bases_Exchange’ (2 dispositivos, diario a las 03:00).
Investigación y resolución de alertas
El panel mostraba 85 alertas activas: 33 fallos de actividad y 52 advertencias. Investigué cada caso para identificar la causa raíz y aplicar la corrección adecuada. Los escenarios de fallo más frecuentes fueron: (1) almacenamiento NAS saturado al 75%+ — requiriendo la eliminación de copias completas antiguas para liberar espacio; (2) servidor fuera de línea o desconectado en el momento del backup — resuelto reprogramando o verificando la disponibilidad del servidor; (3) plan de backup corrupto — requiriendo recrear el plan con un nuevo nombre (misma base + sufijo incrementado) manteniendo la misma política de backup; (4) problema de red (cable defectuoso o NAS saturado) — provocando fallos de transferencia durante el backup.
Cómo triaba una alerta — paso a paso
- 1Paso 1 — Revisión diaria del panelCada mañana abría el panel de Acronis para comprobar el número de alertas activas y el reparto entre errores y advertencias.
- 2Paso 2 — Búsqueda de la causa raíz por alertaPara cada alerta, inspeccionaba el equipo o el plan de backup afectado para determinar cuál de los cuatro patrones de fallo habituales aplicaba (NAS saturado, servidor fuera de línea, plan corrupto, problema de red).
- 3Paso 3 — Corrección en el origenSegún el caso: liberación de espacio en el NAS purgando copias completas obsoletas, verificación de la disponibilidad del servidor, o recreación de un plan corrupto con un nuevo nombre y la misma política.
- 4Paso 4 — Verificación de la continuidadEsperaba o lanzaba la siguiente ejecución programada del plan afectado para confirmar que la alerta quedaba realmente resuelta antes de cerrarla.
Ejemplos de alertas (panel)
- Advertencia SRV-RDS-01
- Backup de VM completado con advertencia: CBT desactivado — backup ejecutado sin Changed Block Tracking (snapshots VMware presentes)
- Error SRV-DB-01
- Replicación fallida — cuota de almacenamiento de la cuenta cloud del cliente superada, los próximos backups fallarán
- Plan SQL-CLOUD 2
- 86 dispositivos respaldados, el plan Bases_Exchange aparece en rojo (fallo) — investigación de saturación de red/NAS
Impacto
Continuidad de backup restablecida en los 105 endpoints protegidos, sin pérdida de datos ni intervención manual recurrente una vez corregidas las causas raíz.
Resultados
- Supervisión diaria
- Revisión sistemática del estado de los backups en más de 100 dispositivos cada mañana
- Resolución de fallos
- Análisis de causa raíz de 85 alertas — almacenamiento, red, disponibilidad de servidores y corrupción de planes
- Gestión de planes
- Planes de backup corruptos recreados sin pérdida de datos, continuidad restablecida
- Gestión de almacenamiento
- Capacidad NAS liberada eliminando backups completos obsoletos, evitando futuros fallos
- Competencias
- Acronis Cyber Backup, Acronis Cyber Protect Cloud, gestión de planes de backup, almacenamiento NAS, triaje de alertas
Buenas prácticas
- Confirmar siempre cuál de los patrones de fallo recurrentes (NAS saturado, servidor fuera de línea, plan corrupto, problema de red) aplica antes de actuar — el mismo estado rojo puede ocultar cuatro correcciones distintas, y equivocarse hace perder un ciclo completo de backup.
- Cuando un plan está corrupto, recrearlo con un nombre incrementado y la misma política en lugar de partir de una configuración en blanco — esto evita cambiar silenciosamente la retención o los destinos de los que depende el cliente.
- Comprobar la capacidad restante de ambos destinos NAS a la vez, no solo el que generó la alerta — si los dos se acercan a su límite, liberar espacio en uno solo retrasa el mismo fallo en el otro.
- Usar el acceso remoto (Datto RMM / Splashtop) para comprobar el estado físico/de red de un servidor antes de suponer que el software de backup es el culpable — un cable desconectado produce el mismo estado rojo que un plan corrupto.
- Cerrar una advertencia solo tras confirmar que la siguiente ejecución programada se completa sin problemas — un estado que parece resuelto sobre el papel puede repetirse si la causa subyacente (como un enlace saturado) no se resolvió del todo.
Límites conocidos y decisiones
- Esta misión era reactiva por diseño: triaba y corregía las alertas ya generadas en el panel en lugar de rediseñar la arquitectura de backup en sí (política de retención, dimensionamiento del NAS) — esa decisión de alcance correspondía al responsable del equipo de Explotación.
- Liberar capacidad del NAS purgando copias completas antiguas reduce la ventana de retención de ese periodo; era la corrección más rápida ante un fallo activo, una decisión asumida por el equipo y no dejada sin documentar.
- Un plan de backup que mostraba «CBT desactivado» (Changed Block Tracking) igualmente se completaba con éxito — lo traté como una advertencia a vigilar y no como un fallo activo, ya que forzar un nuevo escaneo completo de VMware a mitad de ciclo habría costado más tiempo de backup del que habría ahorrado.
- Las categorías de causa raíz (NAS saturado, servidor fuera de línea, plan corrupto, problema de red) cubrieron todas las alertas observadas durante esta misión, pero no son una lista exhaustiva para Acronis Cyber Backup en general — un entorno de cliente distinto podría revelar otros modos de fallo.
Herramientas y referencias
Capturas de pantalla