Supervision des sauvegardes Cloud avec Acronis Cyber Backup
Acronis Cyber Backup · Acronis Cyber Protect Cloud · MIDRANGE GROUP
Contexte
Chez MIDRANGE GROUP (ESN/MSP), au sein de l'équipe Exploitation aux côtés de l'administrateur systèmes & réseaux de l'équipe, j'assurais la supervision quotidienne des sauvegardes cloud et locales pour un client géré. L'infrastructure de sauvegarde reposait sur deux produits Acronis distincts : Acronis Cyber Backup (solution de sauvegarde locale/NAS) et Acronis Cyber Protect Cloud (plateforme de sauvegarde cloud orientée MSP). Ma mission : contrôler quotidiennement le tableau de bord Acronis, trier les alertes actives et rétablir la continuité de sauvegarde à chaque échec détecté.
Défis techniques
- 85 alertes actives sur 105 postes protégés imposaient un triage systématique — traiter chaque alerte avec la même urgence aurait noyé les quelques cas qui présentaient un réel risque de perte de données.
- Le même symptôme (un statut rouge « échec ») pouvait provenir de quatre causes racines distinctes — NAS saturé, serveur hors ligne, plan de sauvegarde corrompu ou panne réseau — la correction devait donc coller à la cause réelle, pas seulement au libellé de l'alerte.
- Recréer un plan de sauvegarde corrompu impliquait de préserver exactement la même politique (planification, rétention, destination) sous un nouveau nom, sans modifier silencieusement les fenêtres de rétention ou les destinations dont dépendait le client.
- Les deux destinations NAS on-premise approchaient simultanément leur plafond de capacité de 10,5 Tio ; libérer de l'espace sur l'une sans vérifier l'autre n'aurait fait que retarder le même échec.
- Diagnostiquer un échec nécessitait souvent un accès distant aux serveurs du client (via Datto RMM / Splashtop) plutôt que de s'appuyer uniquement sur la console Acronis, certaines causes racines (serveur débranché, lien réseau saturé) n'étant visibles que depuis la machine elle-même.
Infrastructure de sauvegarde
- Outil sauvegarde locale
- Acronis Cyber Backup (NAS / cloud privé)
- Outil sauvegarde cloud
- Acronis Cyber Protect Cloud (hébergé chez Acronis)
- Destination NAS 1
- smb://nas-client/backups — 8,77 Tio / 10,5 Tio
- Destination NAS 2
- smb://nas-client/backups-new — 9,57 Tio / 10,5 Tio
- Destination cloud
- Cloud Acronis — 139 Gio / 250 Gio
- Appareils protégés
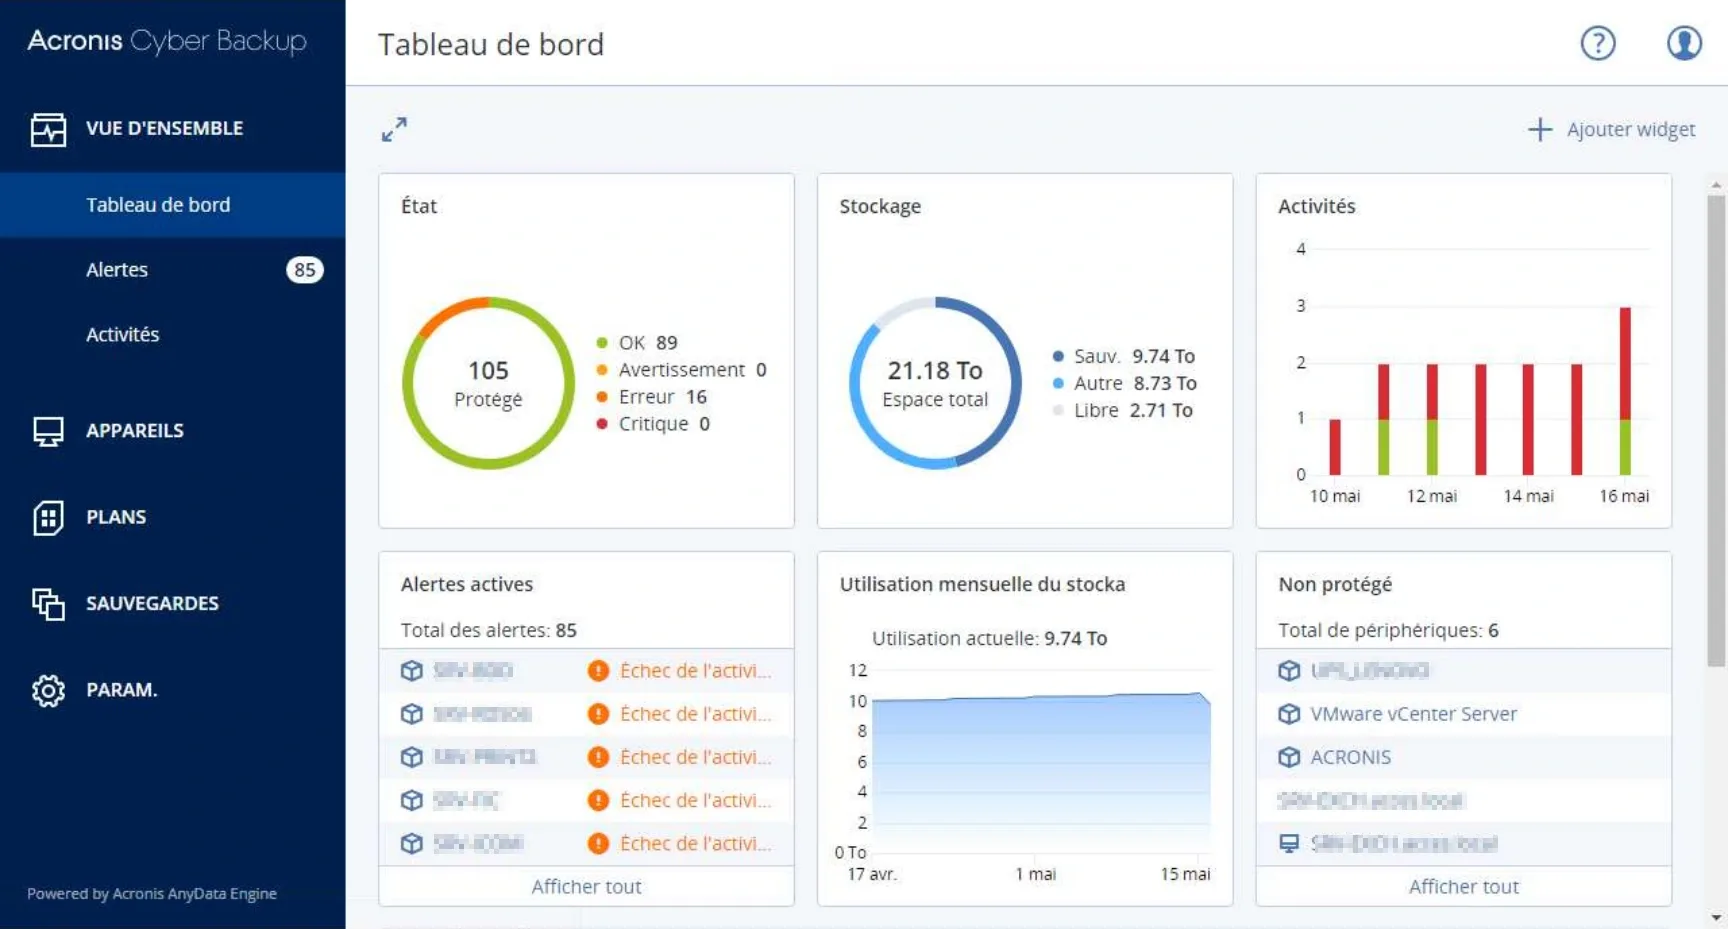
- 105 au total (89 OK, 16 en erreur, 0 critique)
- Appareils non protégés
- 6 (UPS-01, VMware vCenter Server, ACRONIS, SRV-MAIL-01)
- Stockage total utilisé
- 9,74 Tio sauvegarde / 21,18 Tio total
Plans de sauvegarde
Le client disposait de 5 plans de sauvegarde actifs dans Acronis Cyber Backup : 'Toutes les VM' (16 appareils dont SRV-RDS-01, SRV-DB-01, SRV-PRINT-01 et 13 autres — planification Lun–Sam à 23h00, destination : smb backups-new, conservation : 2 mois mensuel / 4 semaines hebdo / 6 jours quotidien) ; 'TMP-BDD' (1 appareil) ; 'SQL-CLOUD 2' (86 appareils, Lun–Ven à 23h00) ; 'SQL-CLOUD' (86 appareils) ; 'Bases_Exchange' (2 appareils, tous les jours à 03h00).
Investigation des alertes & résolution
Le tableau de bord affichait 85 alertes actives : 33 échecs d'activité et 52 avertissements. J'ai investigué chaque cas pour identifier la cause racine et appliquer la correction appropriée. Les scénarios d'échec les plus fréquemment rencontrés : (1) NAS saturé à 75%+ — nécessitant la suppression d'anciennes sauvegardes complètes pour libérer de l'espace ; (2) serveur hors ligne ou débranché lors de la sauvegarde — résolu par reprogrammation ou vérification de disponibilité ; (3) plan de sauvegarde corrompu — nécessitant la recréation du plan sous un nouveau nom (même base + suffixe incrémenté) en conservant la même politique de sauvegarde ; (4) problème réseau (câble défectueux ou NAS saturé) — provoquant des échecs de transfert en cours de sauvegarde.
Mon triage d'une alerte — étape par étape
- 1Étape 1 — Revue quotidienne du tableau de bordChaque matin, j'ouvrais le tableau de bord Acronis pour relever le nombre d'alertes actives et la répartition erreurs/avertissements.
- 2Étape 2 — Recherche de la cause racine par alertePour chaque alerte, j'inspectais l'appareil ou le plan de sauvegarde concerné pour déterminer lequel des quatre schémas d'échec courants s'appliquait (NAS saturé, serveur hors ligne, plan corrompu, problème réseau).
- 3Étape 3 — Correction à la sourceSelon le cas : libération d'espace NAS par purge de sauvegardes complètes obsolètes, vérification de la disponibilité du serveur, ou recréation d'un plan corrompu sous un nouveau nom avec la même politique.
- 4Étape 4 — Vérification de la continuitéJ'attendais ou déclenchais la prochaine exécution planifiée du plan concerné pour confirmer que l'alerte était bien résolue avant de la clôturer.
Exemples d'alertes (tableau de bord)
- Avertissement SRV-RDS-01
- Sauvegarde VM réussie avec avertissement : CBT désactivé — sauvegarde exécutée sans Changed Block Tracking (snapshots VMware présents)
- Erreur SRV-DB-01
- Réplication échouée — quota de stockage du compte cloud client dépassé, les nouvelles sauvegardes échoueront
- Plan SQL-CLOUD 2
- 86 appareils sauvegardés, plan Bases_Exchange en rouge (échec) — investigation saturation réseau/NAS
Impact
Continuité de sauvegarde rétablie sur l'ensemble des 105 postes protégés, sans perte de données ni intervention manuelle récurrente une fois les causes racines corrigées.
Résultats
- Surveillance quotidienne
- Contrôle systématique de la santé des sauvegardes sur 100+ appareils chaque matin
- Résolution des échecs
- Analyse des causes racines de 85 alertes — stockage, réseau, disponibilité serveur et corruption de plan
- Gestion des plans
- Plans de sauvegarde corrompus recréés sans perte de données, continuité rétablie
- Gestion du stockage
- Capacité NAS libérée par purge des sauvegardes complètes obsolètes, évitant de futurs échecs
- Compétences
- Acronis Cyber Backup, Acronis Cyber Protect Cloud, gestion de plans de sauvegarde, NAS, triage d'alertes
Bonnes pratiques
- Toujours confirmer lequel des schémas d'échec récurrents (NAS saturé, serveur hors ligne, plan corrompu, problème réseau) s'applique avant d'agir — le même statut rouge peut cacher quatre corrections différentes, et se tromper fait perdre un cycle de sauvegarde complet.
- Quand un plan est corrompu, le recréer sous un nom incrémenté avec la politique identique plutôt que de repartir d'une configuration vierge — cela évite de modifier silencieusement la rétention ou les destinations dont dépend le client.
- Vérifier la capacité restante des deux destinations NAS ensemble, pas seulement celle ayant déclenché l'alerte — si les deux approchent leur plafond, libérer de l'espace sur l'une ne fait que retarder le même échec sur l'autre.
- Utiliser l'accès distant (Datto RMM / Splashtop) pour vérifier l'état physique/réseau d'un serveur avant de soupçonner le logiciel de sauvegarde lui-même — un câble débranché produit le même statut rouge qu'un plan corrompu.
- Ne clôturer un avertissement qu'après avoir confirmé que la prochaine exécution planifiée s'est bien déroulée sans accroc — un statut qui semble corrigé sur le papier peut réapparaître si la cause sous-jacente (comme un lien saturé) n'a pas été pleinement résolue.
Limites connues & décisions
- Cette mission était réactive par construction : je triais et corrigeais les alertes déjà levées sur le tableau de bord plutôt que de reconcevoir l'architecture de sauvegarde elle-même (politique de rétention, dimensionnement NAS) — ce choix de périmètre revenait au responsable de l'équipe Exploitation.
- Libérer de l'espace NAS en purgeant d'anciennes sauvegardes complètes réduit la fenêtre de rétention sur cette période ; c'était la correction la plus rapide face à un échec actif, un compromis assumé par l'équipe plutôt que laissé non documenté.
- Un plan de sauvegarde affichant « CBT désactivé » (Changed Block Tracking) se terminait tout de même avec succès — je l'ai traité comme un avertissement à surveiller plutôt qu'un échec actif, car forcer un nouveau scan complet VMware en cours de cycle aurait coûté plus de temps de sauvegarde qu'il n'en aurait fait gagner.
- Les catégories de cause racine (NAS saturé, serveur hors ligne, plan corrompu, problème réseau) couvraient toutes les alertes observées durant cette mission, mais elles ne constituent pas une liste exhaustive pour Acronis Cyber Backup en général — un environnement client différent pourrait révéler d'autres modes de défaillance.
Outils & références
Captures d'écran