Déploiement Salesforce avec Heroku (Legarant‑AXG)
Déploiement et intégration Salesforce pour LEGARANT-AXG : API REST, synchronisation Heroku et procédure de mise en production staging → production.
Le contexte métier
LEGARANT est une société d'assurance vie française fondée en 1980 à Nantes, qui gère plus de 1,2 million de particuliers sur Salesforce. Pour accélérer son implantation en Allemagne, elle rachète AXG — un acteur local qui pilotait déjà plus de 50 000 clients sur un CRM interne propriétaire.
La décision structurante est prise en amont du projet : Salesforce reste l'unique système de référence. Pas de coexistence de deux CRM, pas de fédération. Les données AXG doivent donc remonter dans Salesforce en flux unidirectionnel (Allemagne → France), les APIs d'intégration doivent être documentées et testables par un tiers, et les assureurs de terrain doivent disposer d'une application mobile qui lit et écrit dans le même socle.
Trois exigences métier encadrent la conception, avant toute considération technique :
- Aucun doublon de client. Un contact AXG déjà présent côté Legarant ne doit jamais être recréé — sur un portefeuille d'assurance vie, un doublon, c'est un dossier orphelin et un risque de non-conformité.
- Pas de suppression physique. Le secteur assurance impose une conservation longue des données client. Un « DELETE » fonctionnel doit se traduire par une désactivation, jamais par un
DELETESQL. - Un flux intra-UE traçable. Les données de contact allemandes entrent dans une org hébergée pour la France : le flux doit rester documenté et l'accès restreint par le rôle applicatif, pas par un contournement.
Contraintes imposées et ce qu'elles ont dicté
| Contrainte | Origine | Conséquence de conception |
|---|---|---|
| Salesforce = système de référence unique | Décision Legarant | La logique d'identité (unicité, dédoublonnage) doit vivre dans Salesforce, pas dans la couche de synchro |
| Synchronisation à sens unique AXG → Salesforce | Périmètre projet | Pas de résolution de conflit à écrire — mais le sens doit être garanti par l'architecture, pas par convention |
| Conservation réglementaire des données | Secteur assurance | DELETE = passage de IsActive à false ; endpoint dédié, jamais de suppression de ligne |
| APIs testables par un évaluateur externe | Cadre du titre RNCP | Collection Postman complète, exécutable de bout en bout sans ressaisie d'identifiants |
| Budget cloud contraint | Comparatif Azure / Heroku | Heroku Connect retenu : synchro Salesforce native, pas d'ETL maison à coder et à exploiter |
| Application mobile lisant/écrivant dans Salesforce | Besoin terrain assureurs | Connecteur bidirectionnel Heroku ↔ Salesforce + une base Postgres par environnement |
Architecture
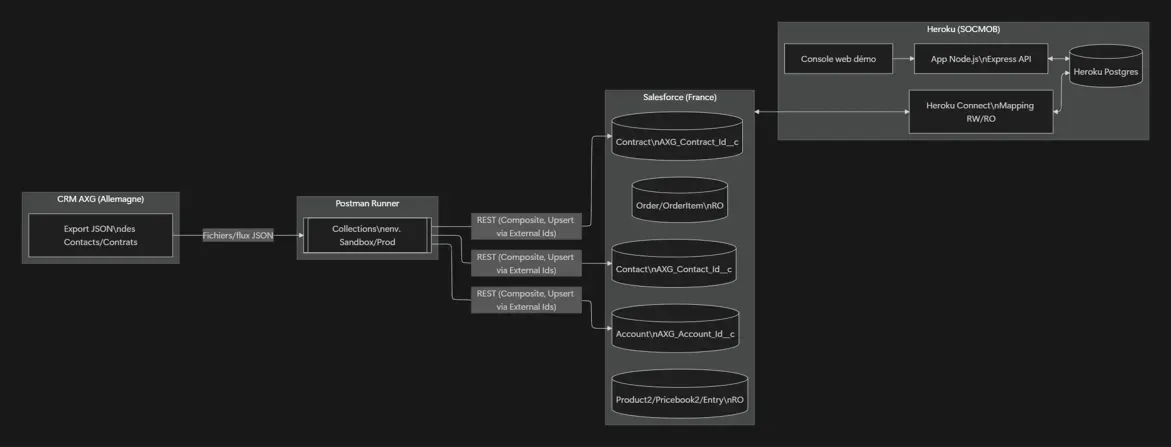
Deux chemins de données coexistent, volontairement séparés.
Chemin 1 — reprise AXG → Salesforce (unidirectionnel).
Données AXG (Allemagne)
   │  HTTPS + token OAuth
   ▼
Contrôleur Apex REST custom (@RestResource)
   │  vérification e-mail préalable · upsert sur External ID
   ▼
Org Salesforce France
   ├─ Trigger Apex : remplissage automatique de l'External ID à la création
   └─ Matching Rule + Duplicate Rule (e-mail, prénom, nom) en mode Alerte
Chemin 2 — application mobile ↔ Salesforce (bidirectionnel).
App mobile assureurs
   ▼
API Node.js / Express (SOCMOB) sur Heroku
   ▼
Heroku Postgres  ◄──►  Heroku Connect  ◄──►  Org Salesforce
                (mapping par objet : RW sur Account/Contact/Contract,
                 RO sur Order/OrderItem/Product2/Pricebook2/PricebookEntry)
Chaque environnement (staging, production) possède sa propre base Postgres, ses propres Connected Apps et son propre jeu de variables de config. Les deux environnements Heroku sont reliés par une pipeline de promotion : on promeut le code de staging vers production, on ne redéploie jamais à la main en prod. Le staging est rattaché à la sandbox Salesforce, la production à l'org de production — aucun croisement possible.
La couche Apex est déployée via Salesforce DX (métadonnées versionnées, pas de Change Set manuel).
Décisions d'architecture (ADR)
| Décision | Alternatives écartées | Pourquoi ce choix |
|---|---|---|
| Heroku Connect pour la synchro | ETL maison ; Azure Data Factory | Azure ne tenait pas dans le budget ; un ETL maison, c'est une couche de plus à coder, tester et exploiter, pour un besoin que Heroku Connect couvre nativement |
| External ID + Trigger Apex pour l'unicité | Dédoublonnage côté Heroku Connect / Postgres | La source de vérité de l'identité reste dans Salesforce — le montage survit à un remplacement futur de la couche de synchro |
| OAuth différencié par environnement : Client Credentials en prod, Username-Password confiné au sandbox | Un seul flow Username-Password partout (plus rapide à câbler) | La production ne repose sur aucun mot de passe stocké ; seuls client_id/client_secret en variables de config |
| Duplicate Rule en mode Alerte, pas blocage strict | Blocage dur à la création | Le contact peut légitimement déjà exister côté AXG : on signale, l'utilisateur métier tranche |
DELETE = désactivation (IsActive = false) | Suppression physique de l'enregistrement | Règle de conservation du secteur assurance — contrainte réglementaire, pas préférence technique |
| API REST Composite pour les écritures en lot | Appels unitaires en boucle | Jusqu'à 25 sous-requêtes / 200 objets par appel : consommation de limites API réduite et cohérence transactionnelle (rollback si une sous-requête échoue) |
Sécurité par conception
La sécurité n'a pas été ajoutée à la fin — elle est dans les choix d'architecture ci-dessus. Concrètement :
- Aucun secret dans le code. Les identifiants OAuth sont des variables de config Heroku, jamais commitées.
- Un utilisateur d'intégration dédié, porteur d'un Permission Set explicite (
INTG_API_Policies_CRUD) qui liste les droits RW/RO objet par objet. Aucun accès API ne passe par un profil générique. - Endpoints Apex REST en HTTPS uniquement, accessibles seulement avec un token Salesforce valide et le Permission Set adéquat — pas d'accès anonyme.
- Client Credentials Flow en production (server-to-server) : pas d'identifiant utilisateur côté Heroku. Le Username-Password Flow existe uniquement pour les tests Postman manuels sur le sandbox et n'est jamais exposé en prod.
- Limites API surveillées en continu via l'en-tête
Sforce-Limit-Infolu sur chaque réponse HTTP — la saturation se voit venir, elle ne se découvre pas via une 403. - Flux de données documenté : contacts AXG (Allemagne) → org France, flux intra-UE, accès borné par permission sets.
Déploiement et exploitation
Le livrable n'est pas seulement du code : c'est un document de déploiement listant les composants livrés, les actions manuelles, et l'ordre d'installation. Une passation ops réelle ne se fait pas en lisant un diff Git.
- Porte de validation : la collection Postman complète (GET / POST / PATCH / DELETE + auth + dédoublonnage + upsert par lots) doit passer à 100 % sur le sandbox avant toute promotion. C'est le go/no-go.
- Promotion : staging → production via la pipeline Heroku. Jamais de déploiement manuel en prod.
- Rollback : côté Heroku, retour à la release précédente via la pipeline ; côté Salesforce, redéploiement SFDX du paquet de métadonnées de la version antérieure. Les métadonnées Salesforce n'ont pas d'annulation native — la procédure est écrite, pas improvisée.
- Observabilité : Papertrail centralise les logs applicatifs des deux environnements en temps réel. Un incident de synchro se lit dans un flux unique, pas en fouillant deux dynos séparément.
Limites assumées
Un projet honnête nomme ce qu'il ne fait pas :
- Pas de résolution de conflit. Acceptable ici : la synchro est à sens unique, il n'y a pas de write concurrent à arbitrer. Ce n'est pas un manque, c'est une conséquence du périmètre.
- Pas de retry/backoff documenté sur les appels Heroku Connect. À l'échelle réelle, il faudrait une file d'attente ou un mécanisme de reprise — hors périmètre du démonstrateur, mais identifié.
- Heroku Connect en Demo Edition : suffisant pour prouver le montage, pas dimensionné pour un volume de production réel.
Résultats
| Indicateur | Valeur |
|---|---|
| Endpoints API livrés | 4 (GET, POST, PATCH, DELETE) |
| Suite de tests Postman | 17 tests, 100 % passés |
| Temps d'exécution / réponse moyenne | 5,7 s au total · 232 ms en moyenne |
| Synchronisation Heroku ↔ Salesforce | Bidirectionnelle, opérationnelle |
| Évaluation du titre RNCP | 2/2 compétences validées — mention Félicitations, architecture jugée propre et bien documentée |
La preuve du croisement de compétences
C'est le point qui distingue ce projet d'un livrable Salesforce classique. J'ai construit la couche Apex REST ET l'application Heroku qui la consomme : API Express + PostgreSQL, deux environnements isolés sur une pipeline Heroku, Heroku Connect configuré objet par objet, jusqu'au runbook de déploiement.
Un profil Salesforce seul se serait arrêté à la couche Apex et aurait confié l'infrastructure Heroku à quelqu'un d'autre — avec le risque classique de décisions prises sans connaître les contraintes de l'autre côté. Un profil infrastructure seul aurait pu déployer l'app Heroku, mais pas concevoir le Trigger Apex d'External ID ni la Matching Rule qui empêchent les doublons à la source. Livrer les deux ensemble a supprimé l'aller-retour habituel entre équipe Salesforce et équipe DevOps : l'environnement de staging existait avant que la première ligne d'Apex ne soit écrite.
Prochaine étape déjà cadrée : migrer le flux sandbox/PoC vers OAuth 2.0 JWT Bearer Flow (certificat plutôt que mot de passe) pour aligner tous les environnements sur un flow server-to-server. C'est le point de départ exact d'un projet de croisement plus poussé — synchronisation temps réel Heroku ↔ Salesforce via Platform Events.
Projet fil rouge du titre RNCP niveau 6 « Développeur Concepteur Logiciel » (OpenClassrooms) : contexte, jeu de données et contraintes imposés, livrable soutenu devant un jury. Il est approfondi ici avec la couche architecture, sécurité et exploitation attendue en contexte professionnel — au-delà du périmètre strict de l'exercice.
Captures d'écran